上一篇介紹了 Exa Search API,讓 AI Agent 可以直接搜尋網路,不需要再透過 Playwright 開啟瀏覽器,也不用自己解析 Google 的搜尋結果
不過搜尋只解決了一半的問題..
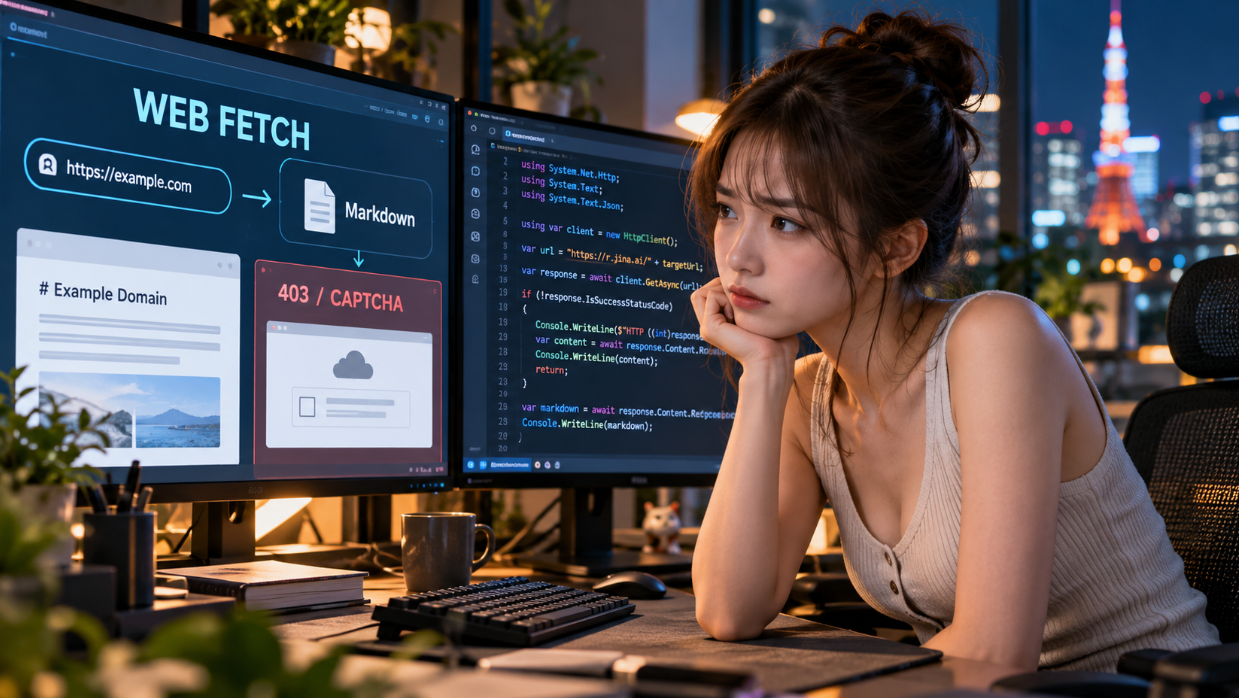
AI Agent 找到網址之後,總要能讀取網頁內容吧,不然只有 Title、URL 跟幾段 Snippet,有些問題根本回答不了...
當然你可以直接用 C# HttpClient 把 HTML 抓下來,再透過 HtmlAgilityPack 或其他 Parser 解析,但現在網站動不動就幾百 KB,HTML 混了 Navigation、Footer、廣告跟一堆 JavaScript,整包丟給 LLM 根本浪費 Token
最近研究了一個服務叫做 Jina Reader,只要在網址前面加上 https://r.jina.ai/,就可以嘗試把網頁轉成 Markdown,這不是正好可以拿來當 AI Agent 的 web_fetch 嗎 XD
Jina Reader 是什麼
Jina Reader 是 https://r.jina.ai/ 提供的網頁內容擷取服務,可以把 HTML 網頁整理成 Markdown,這樣 AI 就可以不用去讀取給人類看的html/css
我拿自己的 Donma Lab 文章來測試
原本的網址
https://donmalab.com/articles/ai-edge-agent-llm-202604301441
只需要改成
https://r.jina.ai/https://donmalab.com/articles/ai-edge-agent-llm-202604301441
就可以嘗試取得轉換後的網頁內容,不需要自己處理 DOM,也不用安裝 Chromium
這跟上一篇的 Exa 剛好可以搭配使用
這樣分工很單純,Exa 負責搜網址,Jina 負責讀內文。分成兩個 Tool
AI Agent 就能自己判斷什麼時候只需要看摘要,什麼時候該進去讀完整內容,不用每次搜尋都把整篇網頁抓回來浪費 Token
而且把大量的html 送給 llm 也是很愚蠢
C# HttpClient 實作 Web Fetch
這次一樣不安裝任何 NuGet,直接使用 .NET Console 和 HttpClient
先看完整程式碼
internal class JinaReaderTest
 {
     public static async Task RunAsync()
     {
         // 這次直接拿自己的 Donma Lab 文章測試
         var url = "https://donmalab.com/articles/ai-edge-agent-llm-202604301441";
         //var url = "https://blogs.microsoft.com/blog/2026/10/12/microsoft-to-expand-azure-maia-system-to-multi-gigawatt-deployments/";
         using var client = new HttpClient
         {
             Timeout = TimeSpan.FromSeconds(45)
         };

         // 在原本的網址前面加上 Jina Reader API
         using var request = new HttpRequestMessage(
             HttpMethod.Get,
             "https://r.jina.ai/" + url
         );

         // 要求回傳純文字格式
         request.Headers.Accept.Add(
             new MediaTypeWithQualityHeaderValue("text/plain")
         );

         // 指定輸出 Markdown
         request.Headers.Add("X-Respond-With", "markdown");

         // 如果有 Jina API Key,可以加入 Authorization
         // request.Headers.Authorization =
         //     new AuthenticationHeaderValue("Bearer", "{YOUR_JINA_TOKEN}");

         try
         {
             using var response = await client.SendAsync(request);

             // 印出 HTTP Status Code
             Console.WriteLine($"HTTP {(int)response.StatusCode}");

             if (!response.IsSuccessStatusCode)
             {
                 Console.WriteLine(
                     await response.Content.ReadAsStringAsync()
                 );
                 return;
             }

             var markdown = await response.Content.ReadAsStringAsync();

             // 簡單檢查是否抓到 Cloudflare 驗證內容
             if (markdown.Contains("cf-challenge", StringComparison.OrdinalIgnoreCase)
                 || markdown.Contains("Just a moment", StringComparison.OrdinalIgnoreCase))
             {
                 Console.WriteLine("可能遇到 Cloudflare CAPTCHA");
                 return;
             }

             Console.WriteLine(markdown);
         }
         catch (HttpRequestException ex)
         {
             Console.WriteLine($"HTTP Request Error: {ex.Message}");
         }
         catch (TaskCanceledException)
         {
             Console.WriteLine("Request Timeout");
         }
     }
 }
程式碼其實很簡單,主要就是把原本的 URL 加上 r.jina.ai/,再透過 HTTP GET 取得 Markdown
這邊我多加了 HTTP Status Code 與 Timeout 處理,因為真的要拿來給 AI Agent 使用,不能假設每一個網址都能正常抓取
另外 X-Respond-With: markdown 是要求 Jina 回傳 Markdown 內容,如果需要 JSON 方便後續處理,也可以改用 JSON 回應格式
結果遇到 Cloudflare CAPTCHA
之前我測試過
https://r.jina.ai/https://dotnet.microsoft.com/
結果沒有順利拿到 Markdown,反而遇到了 HTTP 403 或 Cloudflare 驗證問題
所以別看到官方寫只要加個網址前綴就能抓資料,就以為所有網站都可以 XD
這次把網址換成自己的 Donma Lab 文章,至少可以避開第三方網站內容與存取權限不明的問題,不過是否能成功還是得看 Jina 實際回傳結果
而且 HTTP 403 也不一定就是目標網站 Cloudflare 擋住你,也可能是 Jina 端的存取限制,單靠狀態碼不能直接判斷
如果遇到問題,可以先測其他公開網站,再檢查回傳內容,必要時使用 API Key 或調整 Jina 官方支援的讀取選項
如果目標網站確實不允許抓取,那就應該把它視為失敗,不能把 CAPTCHA 頁面交給 LLM 當成文章內容
如果要整合 AI Agent 呢
其實跟上一篇 Exa 的作法差不多
只需要把這段程式整理成 WebFetchAsync(string url),然後註冊成 Agent 的 web_fetch Tool
當模型需要閱讀某個網址時,由 Agent Host 呼叫 Jina Reader,取得 Markdown 後再交給 LLM
另外抓回來的網頁也是不一定可信資料,Prompt Injection 防護不能少,免得別人在網頁裡面加入一些奇怪資料,當然這就放在寫 Agent 的哲學了
小結論
Jina Reader 我覺得很猛雖然我就沒有深究他底層怎麼處理,但是用起來就是舒服,主要就是省掉了 HTML 解析這件事情或是無腦給 LLM 亂花錢
免費服務本來就不是萬解,遇到 Cloudflare 盾或 HTTP 403 就可能就比較麻煩點了
Jina 只是幫忙抓取網頁、轉成 Markdown 的工具,不是什麼萬能爬蟲
真的碰到反爬蟲比較嚴格的網站,還是得乖乖換其他合法可用的方案(playwright)
不過對一般 AI Agent 的 web_fetch 來說,我覺得已經蠻方便了,至少不用為了讀一篇文章就啟動整個 Chromium
先筆記一下,給需要開發 AI Agent 的人
API 文件 https://r.jina.ai/docs
GitHub https://github.com/jina-ai/reader
---
Before you read this, the article was in a superposition of human and AI. Upon observation, the wave function collapsed into a sleep-deprived developer.


